音声のサンプルレートを下げるとき、単純な間引きで「偽の音」が生まれるのはなぜ?
48 kHzの音声を6 kHzへ変換するとき、8個のサンプルごとに一つ残し、出力のサンプルレートを6000と書けばよさそうに見えます。サンプル数は減り、ファイルの長さも正しく保てます。しかし入力に高い周波数が含まれていると、その成分が元にはなかった低い周波数として現れます。
問いは、サンプルを減らす際に、高域の情報を低域の情報として誤って記録しないためにはどうするかです。成分がすべて分かっている合成信号で、単純な間引きと、フィルター後のダウンサンプリングを比較します。プログラムを実行し、3本の音声ファイルを保存して読み直し、スペクトルも描きました。マイク録音、機器での再生、主観的な聴感試験は行っていません。
6 kHzを選んだのは、8分の1への変換と折り返し周波数を計算しやすくするためです。説明用の設定であり、音楽、音声認識、実際の製品に推奨するサンプルレートではありません。
サンプルレート、音の周波数、長さを分ける
音の周波数は、ある振動成分が1秒に何回繰り返すかを表します。サンプルレートは、1秒に何個の値を記録するかです。900 Hzの正弦信号は48 kHzでも6 kHzでも記録できます。サンプル間隔が変わっても、元の900 Hzを自動的に別の周波数へ変えるべきだ、という意味ではありません。
長さT、サンプルレートfsのデータのサンプル数は T×fs です。今回の入力は2秒で96000サンプルです。どちらの出力も6 kHz、12000サンプルなので、2秒のままです。x[::8] で間引き、出力レートも正しく記録すれば、少なくとも時間の関係は保てています。
元のサンプルをすべて残し、ファイルの表示だけを6 kHzに変更すると、96000サンプルは16秒として解釈されます。これは再生の時間尺度を変える操作で、今回比較するダウンサンプリングとは異なります。ヘッダーのサンプルレートは値同士の時間間隔を示すもので、サンプルの実際の変換を代行しません。
もう一つ大切な量は、ナイキスト周波数 fs/2 です。新しいレートは6000なので、境界は3000 Hzです。通常のベースバンド信号では、境界を超える成分が低い帯域へ折り返し、エイリアシングを起こす可能性があります。実際の設計ではフィルターのための余裕も必要です。Analog Devices:サンプリングとエイリアシング、アンチエイリアシングと実際の余裕
成分がすべて分かる入力を作る
float64配列で2秒の信号を合成しました。900 Hzと3900 Hzの正弦成分を含み、それぞれのピーク振幅は0.4です。0.4は今回の正規化された浮動小数点の振幅で、音圧や実際の再生音量ではありません。純音を二つ使うのは、特定の周波数が入力に存在するかを明確に判断できるためです。
一つ目の経路ではインデックス0、8、16……の値をそのまま残します。二つ目はSciPyの resample_poly を使い、同じ8分の1への変換に低域通過フィルターを含めます。入力は同じで、出力ごとの音量正規化はしません。
中央の1.8秒で測定したピーク振幅は次のとおりです。整数音声として保存する前の測定です。小さな値は上限か十分な有効桁数で記載し、残留成分を簡単に「完全なゼロ」としていません。
| 経路 | サンプルレート | 900 Hzの振幅 | 2100 Hzの振幅 | 3900 Hzの振幅 |
|---|---|---|---|---|
| 合成入力 | 48000 Hz | 0.400000 | < 10^-12 | 0.400000 |
| 8サンプルごとに一つ残す | 6000 Hz | 0.400000 | 0.400000 | 出力のナイキスト範囲外 |
| 低域通過フィルターとダウンサンプリング | 6000 Hz | 0.400543 | 0.0000369 | 出力のナイキスト範囲外 |
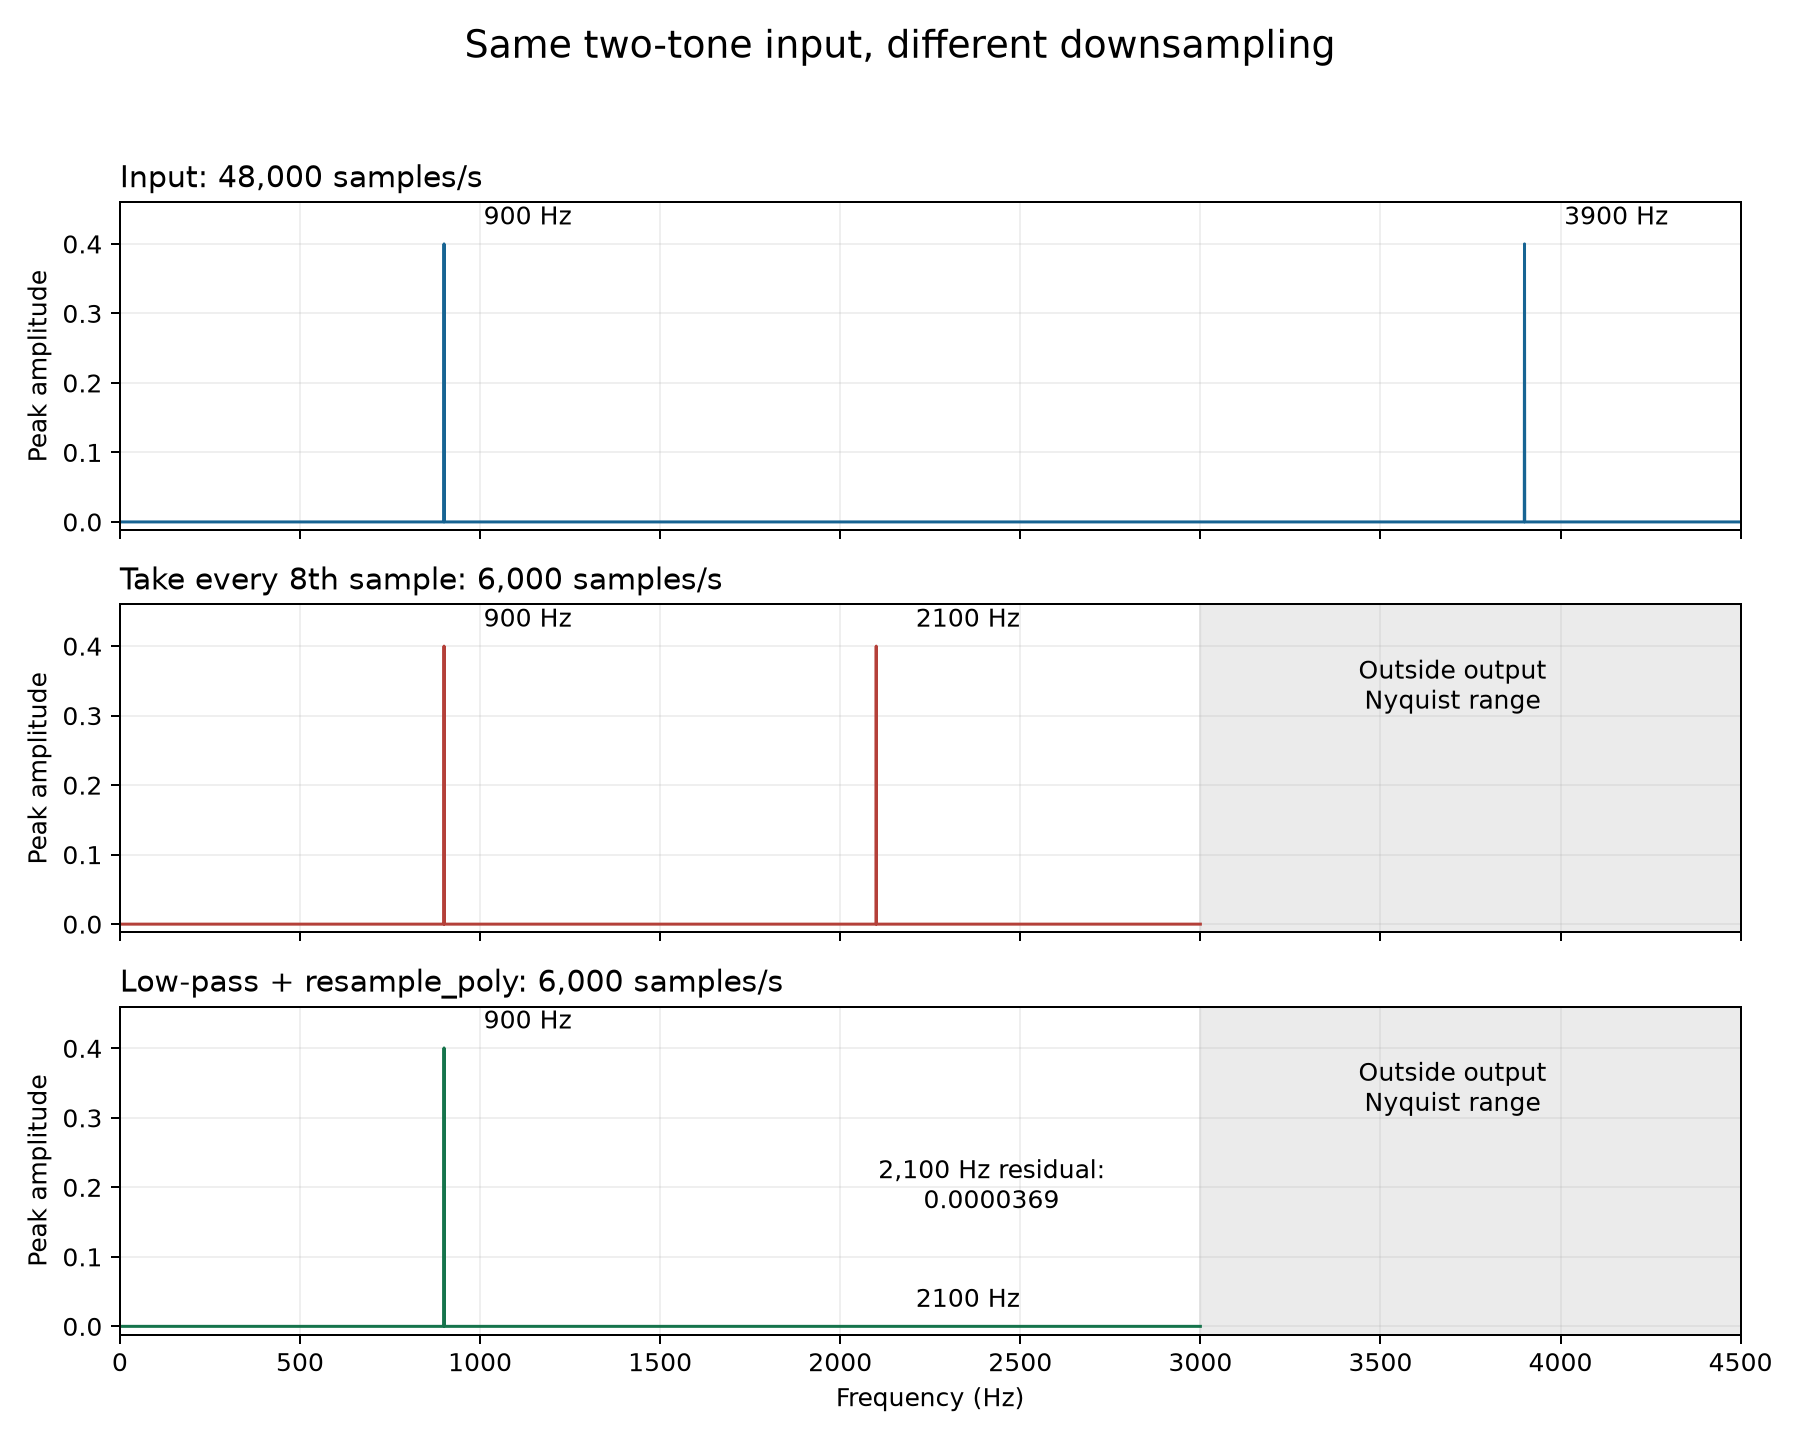
3段とも横軸と縦軸の尺度をそろえています。出力の灰色部分は3000 Hzを超えるナイキスト範囲外で、「その周波数の振幅をゼロと測定した」という意味ではありません。フィルター後の2100 Hz残留は小さく、この線形尺度では見えにくいため、値も別に表示しています。
元の合成音声、単純な間引きの出力、フィルター付きの出力を取得できます。すべてモノラルの16ビットPCMで、長さは2秒です。プログラムで保存後のレート、サンプル数、量子化誤差を確認しました。結論は数値とスペクトルに基づいており、ヘッドホンやスピーカーでの聴感比較を完了したとはしていません。
2100 Hzはどこから来たのか
単純な間引きでは900 Hzは保たれましたが、元の3900 Hz成分が2100 Hzとして現れました。出力に別の発振器を追加したわけではありません。新しいサンプルが粗いため、異なる連続的な変化が、それらの時刻に同じ数値列を残せるからです。
新しいサンプルレート6000について、整数のインデックスnでは次の関係が成り立ちます。
sin(2π × 3900 × n / 6000)
= -sin(2π × 2100 × n / 6000)
3900=6000−2100 なので、サンプルを一つ進めるたびに高い周波数の位相で余分に回る一周は、正弦を取ると消えます。残りは逆位相の2100 Hz正弦と等価です。式の負号は位相を変えますが、振幅スペクトル上の周波数位置とピークの大きさは変えません。
スクリプトでは、3900 Hzだけを間引いた列と、負の2100 Hz正弦の列もサンプルごとに比較しました。最大絶対差は約 3.76×10^-12 で、今回の浮動小数点計算の微小な残差の範囲です。計算できる恒等関係と実際の配列比較の両方があり、スペクトルの画像だけからピークの由来を推測したものではありません。
この二つの例では、6 kHzのサンプルだけを受け取っても、高域の折り返しか、元から対応する低域があったのかを判別できません。だから間引いてから普通の低域通過フィルターを足す方法では解決しません。2100 Hzは、すでに残したい低域の中に入っています。結果を再びアップサンプリングしても、失われた由来の情報は自動的に戻りません。
フィルターを先に適用する理由
アンチエイリアシングの目的は、サンプル間隔を変える前に、新しいレートでは通常の方法で表せない周波数成分を抑えることです。今回の3900 Hzは新しい境界を超えるので、まだサンプルが十分に密な段階で処理します。900 Hzはできるだけ保ちます。そうすることで、レートを下げた後に高域が強い低域成分として入り込むのを防ぎます。
SciPyの公式文書では、resample_poly は up によるアップサンプリング、ゼロ位相の低域通過FIRフィルター、down によるダウンサンプリングを順に行います。ここでは up=1、down=8 で48 kHzから6 kHzにします。Kaiserのパラメーター5.0、padtype="constant" を明示し、境界の外側はゼロと扱います。SciPy:処理の順序と境界設定
実測の2100 Hz振幅は0.4から約0.0000369に下がり、900 Hzは約0.400543でした。後者は少し変わり、前者も厳密にはゼロではありません。有限のフィルターには固有の応答があり、今回をサンプル単位で無損失の処理とは呼べません。一つの周波数の抑制から、すべての周波数で同じ性能とも言えません。
ここでは、6 kHz出力で、今回の通常の音声処理の方法を使いながら、元の3900 Hzまで同時に保つことはできないという取捨選択も必要です。適切な変換は、対象範囲内の内容をできるだけ残し、折り返す成分を抑えることです。用途がその高域を必要とするなら、出力レートを選び直します。低域に折り返して「情報を保持した」と考えることはできません。
レートのちょうど半分にも境界の問題がある
「周波数の2倍のレートがあれば十分」という直感を確かめるため、スクリプトでは 3000 Hz、ピーク振幅0.4 の信号を二つ生成しました。初期位相を0とπ/2にし、同じく6 kHzへ単純に間引きます。
位相0では新しいサンプルが sin(πn) に一致し、理論上はすべてゼロです。実測の最大絶対値は約 3.23×10^-12 でした。位相π/2では値が正負に交互に変わり、実測ピークは 0.4 です。同じ境界周波数でも、位相だけでサンプルの表れ方が大きく変わりました。
これは純音の境界比較で、特定の機器の性能試験ではありません。「1周期に二つの点」を、任意の位相や成分まで完全に保てるという意味で受け取れないことを示します。正式な処理では、必要な帯域を新しい境界より内側に置き、フィルターの遷移域にも空間を用意します。通過域、阻止域、遷移域の条件は実際の信号に合わせて決めます。Analog Devices:実際のフィルターの選択条件
スペクトル測定にも条件を書く
振幅はNumPyの rfft で計算しました。実数入力に対して非負の周波数部分を返し、既定の順変換は正規化されません。そこで一般の周波数項の絶対値に 2/N を掛け、片側のピーク振幅にしています。直流と、偶数長のナイキスト項は2倍にしません。NumPy:rfftの周波数範囲、DFTの定義と正規化
ファイル端でのフィルター過渡応答の影響を減らすため、両端を0.1秒ずつ除き、中央の1.8秒を測りました。この区間で比較する純音は整数周期を含み、周波数の格子点に一致するため、窓を追加しない振幅スペクトルを使っています。この方法は今回の既知の純音に適しています。実際の録音でも、適当な区間を切り出して最も近いピークを見るだけで正確に測れるという意味ではありません。
同様に、両端を外した定常状態の結果がきれいでも、別の用途の端点処理が十分とは証明できません。ブロックごとのリアルタイム変換に継ぎ目がないことも確認していません。今回実行したのは配列全体のオフライン実験で、実際の音声、ストリーミング、各機器の対応は試験範囲外です。
ダウンロードして再現する
環境は macOS 27.0.1、arm64、Python 3.12.14、依存関係は NumPy 2.3.5、SciPy 1.18.1、Matplotlib 3.11.2 に固定しました。完全な実験パッケージを展開し、そのディレクトリで実行します。
python3.12 -m venv .venv
.venv/bin/python -m pip install -r audio-aliasing-requirements.txt
.venv/bin/python audio-aliasing-lab.py audio-aliasing-output
主要な比較は、実行した次の手順で表せます。完全なスクリプトは測定、描画、境界比較、音声の読み直しも行います。
n = np.arange(48000 * 2, dtype=np.float64)
x = 0.4 * np.sin(2 * np.pi * 900 * n / 48000)
x += 0.4 * np.sin(2 * np.pi * 3900 * n / 48000)
stride = x[::8]
filtered = resample_poly(
    x, up=1, down=8, window=("kaiser", 5.0), padtype="constant",
)完全なスクリプト、依存関係一覧、生の測定結果、実行説明も個別に取得できます。3本のWAVは、それぞれを同じピークへ拡大する処理をしていません。一方、浮動小数点配列をPCM16へ変換すると量子化誤差が生じます。表を再計算するときはスクリプトの浮動小数点測定を使います。
実際のファイルでは何を追加確認するか
今回の実験は、サンプル数、出力レート、長さが正しくても、変換内容が正しいとは限らないことを示しました。正式な用途では、残す帯域を決め、それを収められてフィルターの余裕もある出力レートを選び、アンチエイリアシングを含む方法で変換します。その後、実際のファイルのチャンネル、振幅、長さ、端点、受け取るプログラムの形式対応も確認します。
これは今回の例から導く実装上の提案で、音声認識や再生の統合試験を済ませたという意味ではありません。入力がすでにエイリアシングを含んでいたり、残したい周波数が出力範囲を超えたりする場合、一度のリサンプリングだけでは目的を満たせません。元の資料と用途に戻り、変換条件を再検討する必要があります。
最初の問いへの答えは、処理の順序にあります。単純な間引きはサンプル間隔を変えるだけで、折り返す高域を事前には取り除きません。適切なアンチエイリアシングのフィルターを先に使って、低いレートでも対象範囲の内容を記録できる条件を整えます。 正しい形式と長さのWAVは、形式に関する確認の一部を満たした段階です。各周波数がどこから来て、なぜ残ったり抑えられたりするのか説明できれば、変換が想定どおり働いたと判断する根拠になります。