平均十分钟一班,为什么平均会等九分钟?
一条线路平均十分钟来一班,随时到站的乘客,平均是不是等五分钟?如果车辆严格按十分钟间隔出现,且乘客不看时刻表、能登上下一班车,这个答案成立。但“平均间隔十分钟”本身,并没有包含“间隔始终相同”。
班次记录里的平均间隔,和乘客在时间中遇到的间隔,使用的权重不同。 用一组很小的教学时刻表,就能把差异算清楚。下面没有使用真实线路数据,也没有记录个人候车经历;所有数值来自明确设定的循环模型与实际执行的计算。
先把二十分钟里的两段间隔排出来
方案甲在零、十、二十分发车,此后重复。方案乙在零、一、二十分发车,此后也重复。这里观察的是同一站的发车时刻;每个循环末尾的车,也是下一个循环起点的车,不重复当成两班。
甲的两段间隔是十、十;乙是一、十九。按间隔条目计算,两者平均值都为十分钟,长期班次频率也相同。乙只是把车辆安排得更不均匀:前两班靠得近,后面留下一段长空档。
现在让乘客的到站相位在整个循环内连续均匀分布,并且与车辆发车无关。每个人都能登上遇到的下一班车,不考虑满载、步行、换乘或停运。这些条件定义了我们要算的候车问题,而不是计算完之后才补上的例外。
在甲中,无论落进哪段十分钟间隔,剩余等待在零到十分钟之间均匀变化,平均五分钟。MIT 公共交通课程的性能模型课也明确列出这种简化模型的条件,包括乘客到站与发车独立,以及可以登上下一辆车。MIT OCW:第九课,性能模型
但在乙中,不能先说“一分钟间隔平均等半分钟,十九分钟间隔平均等九分半”,然后把这两个结果各取一半。这样的算法偷偷换了到站规则。
长间隔在钟表上,占了更多位置
乙的一分钟间隔只覆盖二十分钟中的一分,十九分钟间隔则覆盖十九分。若到站时间均匀,落入它们的概率分别为二十分之一与二十分之十九。长间隔不是因为乘客更容易记住坏经历而变重要,而是在这个模型中本来就更容易被遇见。
因此,两种间隔对平均等待的贡献应按时间加权:
(1/20) × (1/2) + (19/20) × (19/2) = 181/20 = 9.05 分钟。
也就是九分三秒。相比均匀发车的五分钟,多出四分三秒,但车辆总频率并没有降低。模型里增加等待的原因,是班次分布不均匀。
如果先等概率抽一个间隔,再在那个间隔中均匀抽到站位置,确实会得到五分钟。但那相当于先让短间隔和长间隔各自分到同样多的乘客,再选择位置,并不是在整个二十分钟里均匀到站。两个计算都可以自洽,回答的却不是同一个问题。
同样的加权也影响“乘客所处间隔到底多长”。按班次条目平均是十分钟,按时间遇到的间隔长度平均则为十八点一分。不要把这个十八点一分又当作等车时间:它包括乘客到站前已经过去的部分,剩下要等的部分才是前面的九点零五分。
这类差别提醒我们,看到一个平均值,应先确认是谁被等权计算。按车辆、按间隔、按钟表时间或按乘客统计,可能得到不同结果;换了抽样单位,不能只保留原来的平均公式。
等待曲线下面的三角形,可以直接给出答案
在一段长度为 h 的间隔中,刚错过一班车时要等接近 h,越靠近下一班,剩余等待越短。把横轴画为到站时间,纵轴画为剩余等待,区间内部是一条向下的直线,下面的面积为 h²/2。
把各段面积相加,再除以总时间,便得到整个循环的时间平均等待。这是一份有限循环时刻表的直接积分,不需要把相邻间隔假设成独立随机变量。
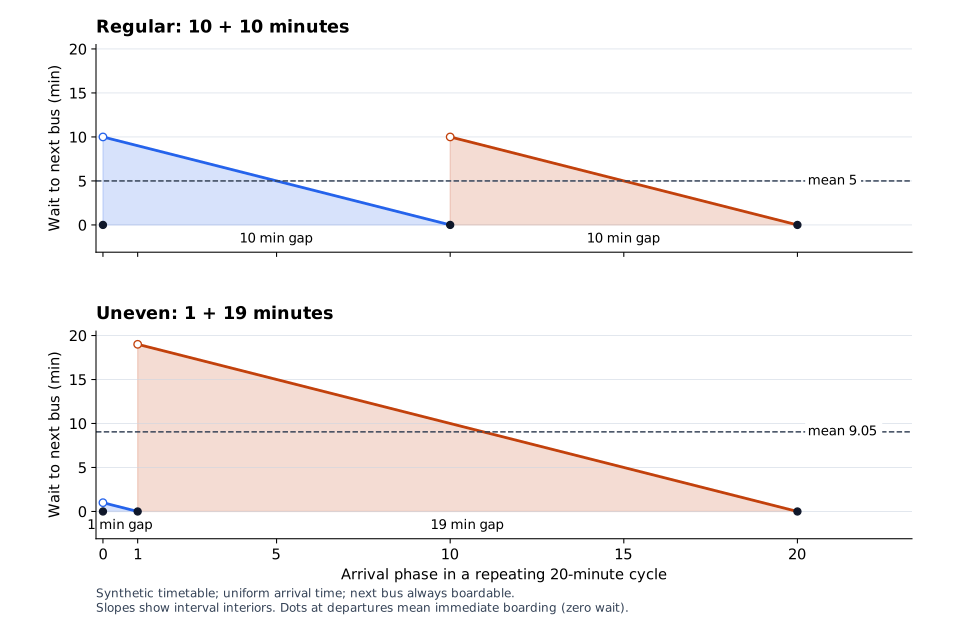
原创教学图。横轴为到站相位,纵轴为到下一班的等待;阴影面积除以二十分钟就是平均等待。斜线表示间隔内部,发车时刻的实心点按可立即登车记零;这些单个端点不改变连续时间平均。
一般写成:平均等待 = Σ(hᵢ²) / (2Σhᵢ)。它不是“平均间隔的一半”,因为先平方再求和,不能与先平均再平方互换。
若把按间隔条目计算的平均值记为 μ,把这一循环内按条目计算的总体方差记为 v,同一式子可以改写成 μ/2 + v/(2μ)。这里方差除以条目数,不是用条目数减一的样本方差估计量。
乙的间隔平均为十,方差为八十一平方分钟,因此平均等待是五加四点零五。只要平均间隔固定且为正,方差项就不会为负;在这些假设下,让间隔更均匀可以减少这项额外等待。
这个结论必须保留“平均间隔固定”的前提。如果为了排得整齐而减少班次,平均间隔也会改变,不能拿上面的比较直接保证乘客一定受益。模型说明的是不均匀的代价,还没有替运营者选定一项调度措施。
平均值之外,还要看长时间等待占多少
实际执行的计算不仅给出平均等待,也计算“等超过五分钟”的比例,以及第九十百分位等待。后者表示在本模型下,九成均匀到站的乘客等待不超过这个值,而不是保证每个人都能在它以内上车。
| 循环间隔,分钟 | 平均间隔 | 平均等待 | 等超过五分钟 | 第九十百分位等待 |
|---|---|---|---|---|
10, 10 | 10 | 5 | 50% | 9 |
5, 15 | 10 | 6.25 | 50% | 13 |
1, 19 | 10 | 9.05 | 70% | 17 |
1, 1, 28 | 10 | 13.1 | 约 76.67% | 25 |
第二行与第一行,“等超过五分钟”的比例完全相同,平均等待和第九十百分位数却更高。只盯住一个阈值,仍然可能漏掉等待分布中的变化。第四行还表明,在这类不均匀安排中,平均等待甚至可以超过按班次记录的平均间隔。
这些比例可以直接从时间长度算出。对任意非负阈值 w,每段间隔里需要等超过 w 的时间长度为 max(hᵢ-w, 0);把长度相加除以循环总长,便是对应比例。乙在十九分钟间隔的前十四分钟需要等超过五分钟,所以比例为十四除以二十。
长空档有时与车辆成串出现相伴。MIT 的服务可靠性课程讨论了这种现象及其对乘客等待的影响,也区分了高频服务的间隔规律性与低频服务的准点问题。MIT OCW:第二十课,服务可靠性本文的一、十九安排只是用于隔离加权机制,没有模拟拥堵、上下客或车辆相互追赶的过程。
到站方式变了,问题就需要重算
“均匀到站”不是乘客的普遍行为定律。如果甲的乘客每次看好时刻,在第九分和第十九分到站,并都能如约上车,两次都只等一分钟。脚本实际检查了这个反例:车辆间隔未变,乘客到站规则改变,平均等待就不再是五分钟。
同样,如果乘客在某一时段大量到站,均匀时间平均就未必等于乘客平均。要计算乘客体验,需要把相应的到站密度放进权重。若满载导致下一班不能上,等待终点也变了,仅知道两班车之间的时间还不够。
本模型采用无限重复循环,因而不会遇到“今天已经没有下一班”。真实运营有首末班,观测窗口也有边界。如果只拿某小时内发出的车作间隔,却漏掉跨越小时边界的长间隔,会改变所研究的样本。需要先定义统计窗口、完整间隔和未完成的等待如何记录,再谈套用公式。
另外,这里的均匀到站是连续时间的设定,不能用“只在每次发车时到站”来验证它。在脚本中,恰好赶上发车记为等待零;但连续均匀抽样落在某一个精确时刻的概率为零,这些端点不影响平均。它们仍值得单独测试,以免程序在查找下一班时无意多等一个循环。
如何复现这些数值,以及它们没有证明什么
本次于 2026 年 11 月 2 日在 macOS 27.0.1、arm64、CPython 3.12.14 下执行。脚本用 Python 标准库的精确分数计算积分结果,另在每个一秒小格的中点查询下一班车。所有发车时刻和所检查的整数分钟阈值都落在小格边界,区间内等待又是线性的,因此这份中点遍历精确复核了平均值与所列阈值比例,不是随机抽样得出的近似。Python:Fraction
共检查七组时刻表,包括单一间隔、两班同时出现的零间隔,以及把一、十九反向排列。脚本还验证了时间整体放大时等待同比放大,拒绝空列表、全零周期、负数与不符合输入约定的类型,并检查八个边界到站时刻。
零、二十的间隔安排得到平均等待十分钟:两班同时出现不能把后面的二十分钟空档变短。全零安排则没有正的循环时长,不能定义本例的均匀到站,脚本会拒绝。这些边界让“零”与“模型没有定义”不被混在一起。
可下载完整实验包,或分别取得脚本、结果报告、原创图和说明。计算报告只依赖标准库:
python3 headway-waiting-lab.py > rerun.json配图由同一脚本的可选绘图分支使用 Matplotlib 3.11.2 生成,重画方法写在附件说明中。这里没有测试实时公交接口,也没有证明某条线路的实际候车分布。九点零五分是这份教学安排及其到站条件的准确答案,不能直接转成某个站台的出行预测。
下次读到“平均十分钟一班”,可以先分清它描述的是计划间隔、实际间隔,还是乘客等待。再问间隔是否均匀、乘客怎样到站、是否都能登上下一班。把权重和条件补齐,同一个“十分钟”才会成为能够正确解释体验的数字。