老报纸里搜不到一个词,能说明它没出现过吗?
查家族史、地方史,或者追一条旧新闻的出处时,全文搜索非常诱人:输入人名、地名,等结果出现。如果页面显示零条,我们似乎就能省去翻阅几十期报纸的工作,宣布“当时没有这条消息”。
但零条结果到底否定了什么?是事情没有发生,报纸没有报道,相关版面没有上线,还是电脑没有认出那个词?这些情况会在搜索框里留下相似的表面结果,却需要完全不同的后续工作。
本文用美国国会图书馆的历史报纸项目 Chronicling America 作为具体案例。材料包括馆方公开的图文对照、收藏说明、研究指南和文字重处理记录。这里不评估全站识别准确率,也不把一张旧截图的状态写成今天的查询结果。
先辨认自己正在读哪一层材料
数字报纸至少有三个值得分别查看的对象:页面影像、机器识别文字,以及帮助定位它们的题录信息。OCR,即光学字符识别,把图像中的文字转换成可由软件处理的字符。国会图书馆的技术说明明确提示,识别文字可能有错误。馆方:OCR 技术说明
| 对象 | 能帮助回答的问题 | 需要保留的限制 |
|---|---|---|
| 题录与期次信息 | 这是什么报纸、哪一期、哪个版面? | 有记录不等于所有期次都已数字化 |
| 扫描影像 | 被拍摄的页面上,字形和版面怎样排列? | 模糊或缺损的地方仍可能读不清 |
| OCR 文字 | 软件把哪些字符交给了检索? | 字符、分词和阅读顺序可能出错 |
| 搜索结果 | 当前条件下,系统返回了哪些候选项? | 命中与否还受范围和匹配方式影响 |
这个区分会改变查证顺序。搜索先帮我们找到可能相关的页,再回到影像核对具体文字与上下文。若把结果摘要直接当成一份可靠誊录,就把用于发现线索的中间产物,提升成了尚未完成的阅读结论。
影像本身也需要辨认。它可能是根据缩微胶片制作的数字图像,并不等同于拿着最初那张纸现场阅读。知道中间经过什么载体,才容易理解为什么某道折痕、某处污损或模糊会进入后续识别。
一个单词怎样在可搜索文字里变了样
馆方在 2024 年 4 月 9 日的介绍中,给出一处很具体的错读:subject 被识别成了 fubjed。长体 s 的字形与 f 相似,连写的 ct 又被识别为 d。这是原页字形到机器字符之间的变化。馆方:新罕布什尔州报纸与检索案例
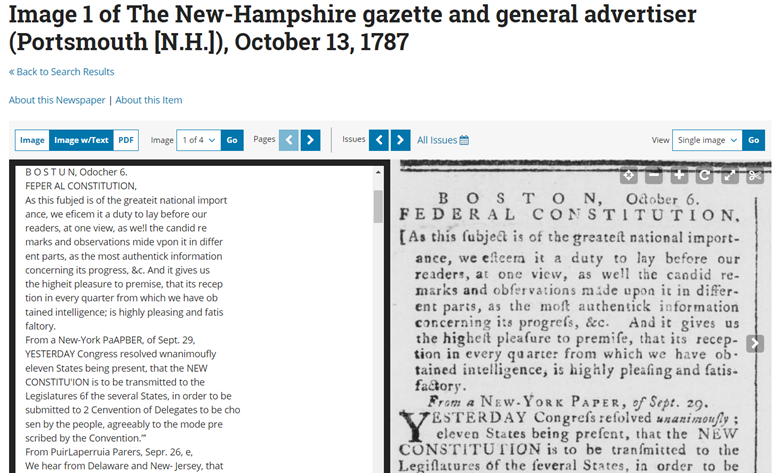
国会图书馆公开的对照截图,保留原文件。题头标注《The New-Hampshire gazette and general advertiser》1787 年 10 月 13 日的第 1 图;左侧是 OCR 文字,右侧是页面影像。截图来自上述 2024 年文章,展示的是当时的界面与案例。
我对照了这张图:右侧段落中的词,在左侧文字开头变成了另一串字符。这里不需要设想电脑“忘掉”了一整篇报道。只要关键字的字符发生变化,针对正确拼写的严格匹配,就可能错过这个位置。
不过,这不等于在当前网站搜索 subject 一定得不到这张报纸。该词可能在其他位置被正确识别,系统也可能采用其他匹配方式,文字还可能已重处理。截图能证明一个具体的识别差异,不能独自证明一次尚未执行的全站搜索会返回什么。
这也是核对材料时需要克制的地方:能够直接看见的,是图像与对应文字的差异;由此可以解释一种漏检机制。要测量漏检有多普遍,还需要有代表性的样本、人工核对和明确的查询条件。
先问有没有这批材料,再问有没有这个词
即使识别完全正确,搜索也只能作用于进入检索范围的材料。馆方的收藏指南说明,Chronicling America 的报纸由参与机构选择并数字化,主要利用缩微胶片等馆藏材料。它是经过选择和持续建设的数字收藏。馆方:收藏范围与建设方式
因此,查某城某年的消息时,先核对报纸名称、出版地和可用期次。目录里查到一种报纸,解决的是识别与定位的问题;目标月份是否上线、某一期是否缺页,还要继续检查。一个覆盖许多地区的大平台,也不能自动替某个具体日期提供完整性证明。
假设要找某人的讣告:如果目标月份没有数字影像,换十种姓名拼写也不能搜索那批尚未进入系统的页。如果目标期次存在,但只搜索了另一份同名报纸,增加模糊匹配同样没有解决范围错误。不同原因的空结果,需要不同的修正办法。
这里还有“没有报道”和“没有发生”的距离。即使确认一份报纸某期没有写到某事,也只能约束这份材料里的报道情况。要讨论事件是否发生,还需要适合回答该问题的其他证据,例如同时期的另一种记录。多换几个搜索词,并不会自动补齐这个推理步骤。
拼写正确,也未必是当时使用的写法
馆方同一篇检索案例还提示历史词汇与拼写的差异,例如旧写法 authentick 和今天常见的 authentic。这类差异需要与 OCR 错误分别记录:前者可能确实印在纸上,后者是识别阶段改变了字符。馆方:历史拼写提示
这个区别决定了怎么改检索方案。遇到识别错误,可以根据已经看到的错误字符尝试另一个查询;遇到历史用词,则应先阅读同一时期的实际材料,收集当时怎样称呼某地、某种机构或某件事。两者都不适合无限枚举自己想象的变体。
短语还增加了另一层要求。对整句的精确匹配,需要相关字符按相应顺序出现。即使单个词大致正确,跨行断词、标点和阅读顺序的差异,也可能影响某种严格匹配。具体服务怎样处理它们,要查该服务的说明;不能把本地字符串匹配的规则直接套给所有档案搜索。
一个务实的办法,是先选较少但有辨识度的词,缩小时间和报纸范围,再逐步增加条件。过短的人名可能带来很多无关页,完整引语又可能要求过强。调整条件是在改变发现线索的方式,最后仍要回到影像确认是不是同一个人、同一件事。
找到线索后,怎样完成一次能复查的阅读
先保存具体对象的信息:报纸名称、期次日期、版面或图像序号、馆方页面链接。文章的转载日期、报道中的事件日期和报纸的出版日期,可能承担不同作用。不能看到几个日期相近,就把它们合并成一条时间线。
接着把命中的位置放回完整段落,看清它属于新闻、广告、引文还是其他栏目。同一个词出现,并不保证它在陈述你要查的那件事。一段文字也可能是在转述他人的说法;看到文字存在,和证明文字所说的事情属实,需要分别判断。
当前馆方指南介绍了 Image w/ Text 的并排查看方式,也说明可下载影像与 OCR 文件。遇到关键字形时,把可读的影像与对应识别文字放在一起,比反复复制搜索摘要更有帮助。馆方:查看图像与 OCR 文字
若要引用,按影像核对誊录,并清楚标注补字、存疑或采用现代拼写的处理。为方便检索建立的词形,可以保存在笔记的另一栏。这样,后来的读者既能找到材料,也能知道某个字是原文如此、机器误读,还是整理者做了转换。
| 建议记录的项目 | 对复查的实际作用 |
|---|---|
| 报纸、日期、版面与稳定链接 | 重新找到同一对象 |
| 检索日期、词语与筛选范围 | 理解这次结果对应什么条件 |
| OCR 原样与影像核对后的读法 | 保留机器结果与人工判断的差别 |
| 未上线、缺页、模糊或未检查的部分 | 说明负面结论覆盖不到哪里 |
| 下一步要查的期次或其他来源 | 把没有结果转换成具体工作 |
这份记录不需要写成复杂数据库。几行能让自己下次继续、也让别人复查的笔记,就比一个只有“没搜到”的截图更有用。
老报纸没有改字,可搜索的文字仍会变化
还要给检索结果加上时间。馆方在 2025 年 4 月 29 日介绍了 OCR 重处理工作,并展示同一段材料在处理前后的识别文字差异。原有影像中的内容可以因此变得更容易被发现。馆方:改进机器可读文字
这项工作也有后续:2026 年 8 月 11 日的馆方文章介绍了相关开源软件及数据集入口。它说明整理与识别仍在持续改进;本文没有安装该软件,也没有验证其处理性能。馆方:重处理软件与数据集说明
因此,两次查询不一致,未必是过去的报纸内容发生了改变。资料新增、识别文字更新、索引和查询条件变化,都可能影响发现结果。馆方的网站迁移说明也明确提醒,改进索引和新增内容后,旧搜索链接的结果可能不同。馆方:网站迁移与搜索变化
对具体研究来说,记录查询日期有两个好处:日后知道当时用到哪一阶段的资料,也能在有更新后重新检查关键的空结果。重要发现最好保存对应影像及来源信息,避免只留下一个会随着系统变化的结果列表。
但“将来可能改进”不是推迟所有阅读的理由。已经读清并定位到原页的材料,可以据其内容继续分析。需要保持开放的,是哪些材料被搜索漏掉,而不是把每条已经核对过的文字都当成同样不确定。
怎样把“没有找到”写成有用的结论
最弱的记录只有“某词,零条”。更有用的写法,是说明在哪个收藏、什么日期范围、哪些报纸与期次、使用哪些查询、人工检查了多少范围。描述越清楚,别人越容易判断这次没有结果究竟排除了什么。
例如,“在指定报纸已上线的某月版面中,用已记录的几种姓名写法检索,尚未找到对应条目”,是在限定材料和方法。“逐页检查已列出的某期版面,未见该条消息”,又增加了另一种检查。这两句是记录格式示例,本文没有执行其中假设的家族史调查。
负面证据并非一律没有价值。若材料范围、期次完整性和人工检查过程都足够清楚,可以对那个范围内是否存在特定文字作出更有力的判断。问题在于,结论的范围要随证据一起扩大,不能直接从一个查询框跳到整个历史世界。
本次于 2026 年 10 月 15 日核对了上述馆方说明,并查看其公开对照图。可下载阅读与来源记录,其中保留图像来源、核对内容和未验证范围;没有虚构实时命中数,也没有把界面访问失败当成零搜索结果。
开头的问题因此可以回答:搜不到一个词,首先说明当前查询没有返回对应线索。要据此判断原页有没有这个词,必须继续检查材料覆盖、历史写法、识别文字与影像。 全文搜索让我们更快接近老报纸;完整的查证,要把搜索之后那一步阅读也做完。