降低音频采样率,为什么直接抽点会造出“假音”?
把 48 kHz 音频转换成 6 kHz,看起来有一个很省事的做法:每八个样本保留一个,把输出采样率写成 6000。样本数确实少了,文件时长也能保持正确。但如果输入里有比较高的频率,这种处理会把它变成原本不存在的低频成分。
问题是:减少采样点时,怎样避免把高频信息误写成低频信息? 本文用一段成分完全已知的合成信号,比较直接抽点与先滤波再降采样。我实际运行了程序,保存并重新读取了三份音频文件,也绘制了频谱;没有进行麦克风录音、硬件播放或主观听感测试。
这里选择 6 kHz,是为了让八倍降采样和折叠频率都容易核算,属于教学设置。它不是对音乐、语音识别或任何真实产品的采样率推荐。
先分清采样率、声音频率与时长
声音频率表示某个振动成分每秒重复多少次;采样率表示每秒记录多少个样本。一个 900 Hz 正弦信号可以被以 48 kHz 记录,也可以被以 6 kHz 记录。两次记录的样本间隔不同,并不意味着应该把原来的 900 Hz 自动变成另一个频率。
对于时长为 T、采样率为 fs 的数据,样本数是 T×fs。本实验输入两秒,有 96000 个样本;两种输出都为 6 kHz,各有 12000 个样本,仍然是两秒。用 x[::8] 抽点的同时正确写入输出采样率,至少把时间关系保持住了。
如果保留原来全部样本,只把文件标注改成 6 kHz,96000 个样本会被解释成 16 秒。那会改变播放时间尺度,不是本文比较的降采样。文件头中的采样率描述样本的时间间隔,不能代替实际转换样本。
另一个关键量是奈奎斯特频率 fs/2。本例新采样率为 6000,因此边界在 3000 Hz。普通基带信号中,超出这个边界的成分可能折叠进较低频段,造成混叠;实际设计还要给滤波留出余量。Analog Devices:采样与混叠、抗混叠滤波与实际余量
造一段所有成分都已知的输入
我用 float64 数组合成两秒信号:900 Hz 和 3900 Hz 两个正弦成分,各自峰值幅度为 0.4。0.4 是这里的归一化浮点幅度,不是声压或实际播放音量。选择两个纯音,是为了能明确判断某个频率在输入中是否存在。
第一条路径直接保留索引 0、8、16……的样本;第二条路径调用 SciPy 的 resample_poly,采用相同的八倍降采样比,并包含低通滤波。两者接收同一输入,不对输出分别做音量归一化。
下面是中央 1.8 秒的实测峰值幅度。表格测量在保存为整数音频之前进行;极小值保留为上界或足够的有效位数,避免把残余成分简单写成“完全为零”。
| 路径 | 采样率 | 900 Hz 幅度 | 2100 Hz 幅度 | 3900 Hz 幅度 |
|---|---|---|---|---|
| 合成输入 | 48000 Hz | 0.400000 | < 10^-12 | 0.400000 |
| 直接每八点取一点 | 6000 Hz | 0.400000 | 0.400000 | 超出输出奈奎斯特范围 |
| 低通滤波并降采样 | 6000 Hz | 0.400543 | 0.0000369 | 超出输出奈奎斯特范围 |
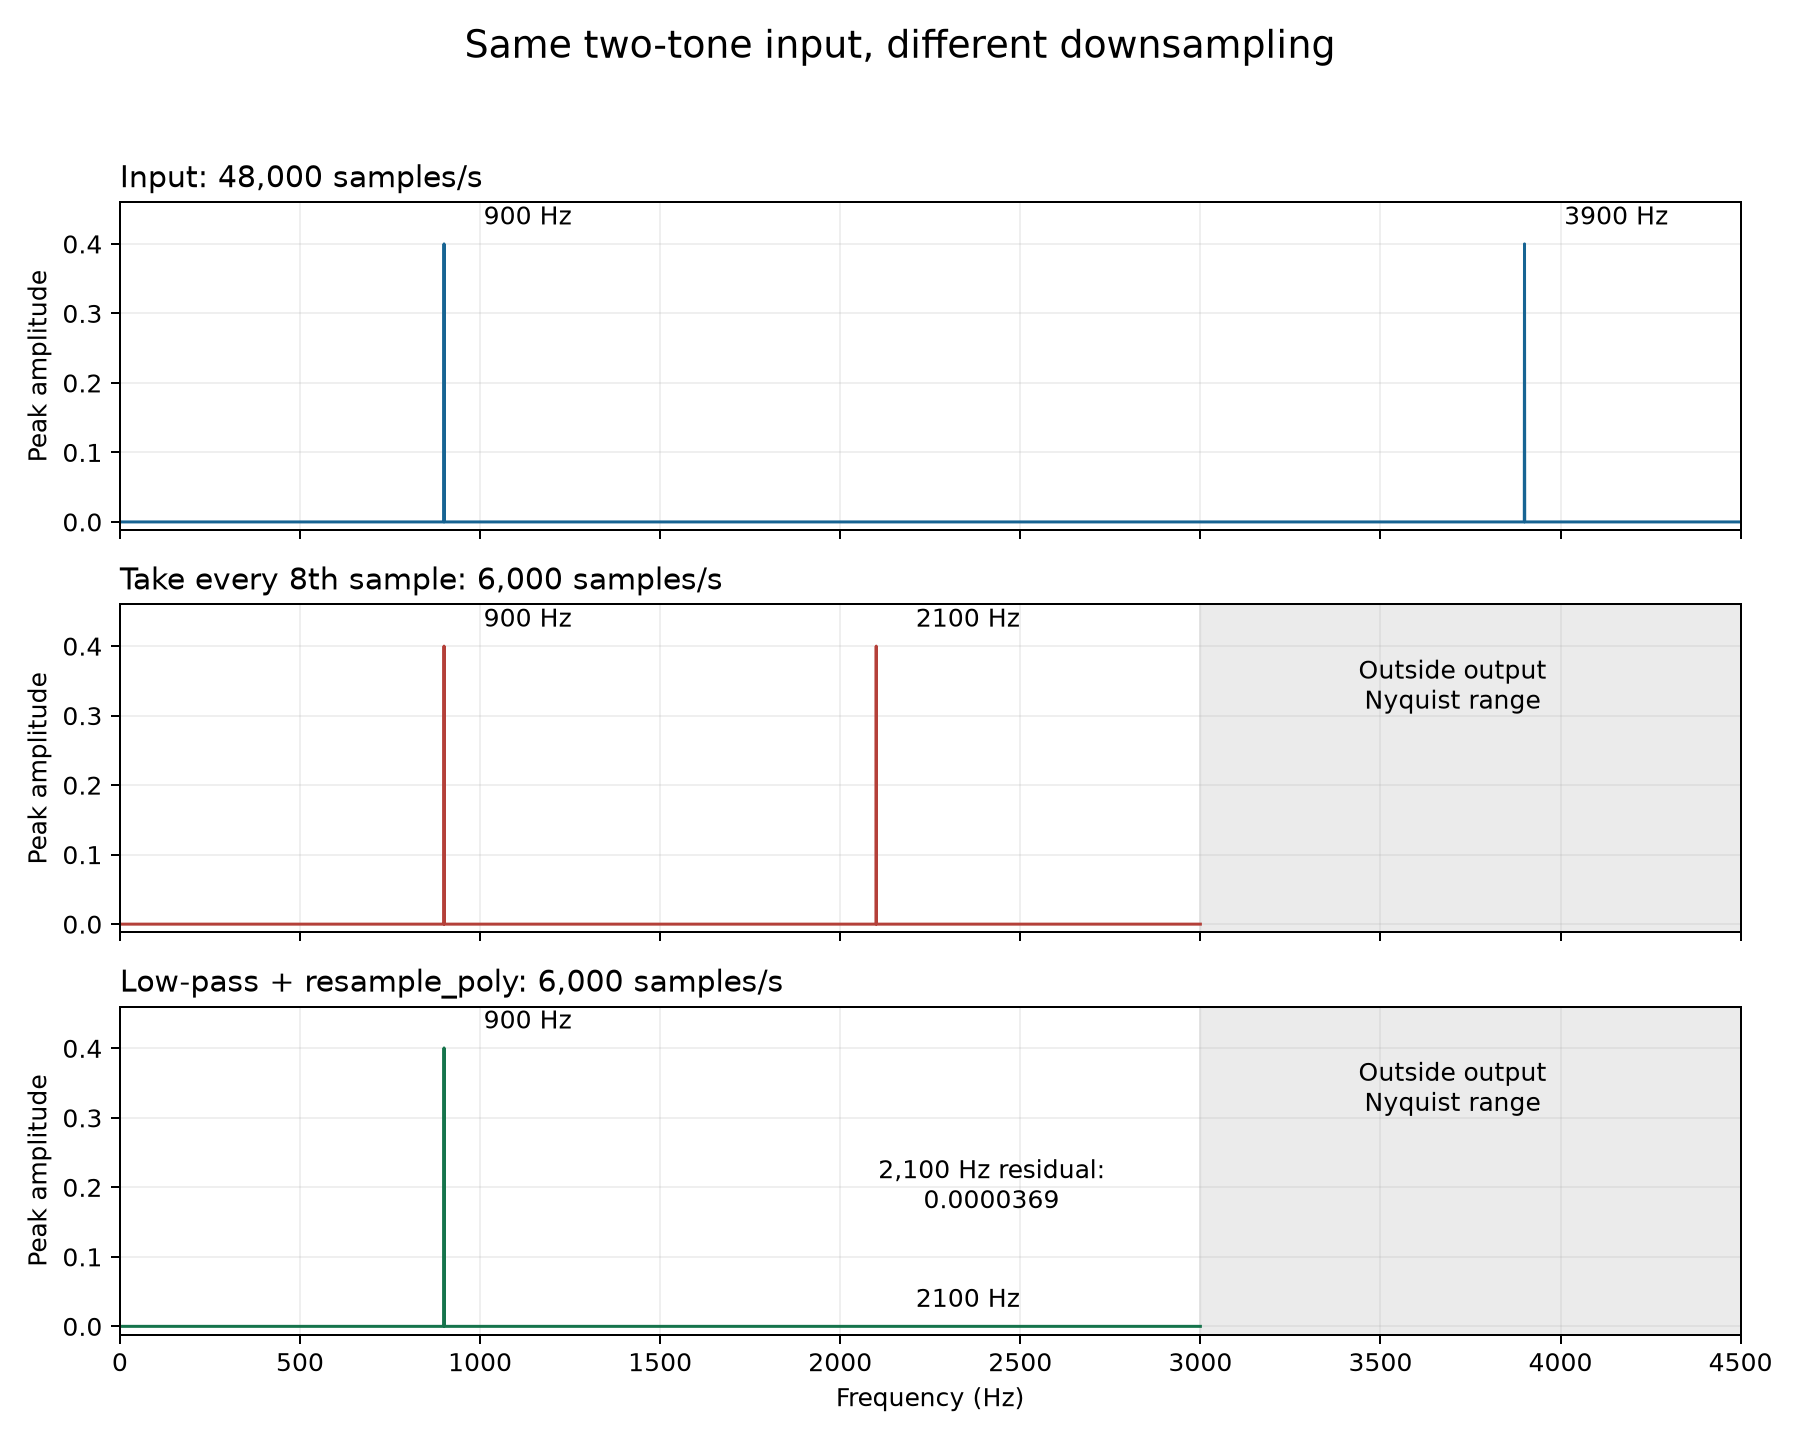
三幅图采用同一横轴和纵轴尺度。输出图的灰色区域表示超出 3000 Hz 的奈奎斯特范围;它不是“这些频率的幅度已经测得为零”。滤波后的 2100 Hz 残余很小,在这个线性尺度下难以看出,因此图中另外标出了数值。
可以分别下载原始合成音频、直接抽点输出和滤波输出。它们是单声道、16 位 PCM,时长均为两秒。程序核对了保存后的采样率、样本数和量化误差;本文的结论来自数值与频谱,没有声称完成耳机或扬声器上的听感比较。
2100 Hz 从哪里来?
直接抽点保住了 900 Hz,却把原来的 3900 Hz 成分表现成了 2100 Hz。这不是在输出里额外加了一个振荡器。原因是新采样点太稀,两个不同的连续变化,可以在这些时刻留下相同的数值序列。
以新采样率 6000 为基准,对每个整数样本索引 n,有如下关系:
sin(2π × 3900 × n / 6000)
= -sin(2π × 2100 × n / 6000)
因为 3900=6000−2100,每增加一个样本,高频相位多转的完整一圈在取正弦时消失了,剩下的变化等效于一个反相的 2100 Hz 正弦。公式中的负号改变相位,不改变我们在幅度谱上看到的频率位置和峰值。
脚本另外把 3900 Hz 单独抽点后的序列,与 负的 2100 Hz 序列逐点比较。最大绝对差约为 3.76×10^-12,处于本次浮点计算的微小残差范围。这里既有可核算的恒等关系,也有实际数组对照,不是仅凭一张频谱猜测峰的来源。
对于这两个例子,只拿到 6 kHz 的样本,无法判断来源究竟是高频折叠还是原本就有相应的低频。这种歧义解释了为什么不能等抽点后再补一个普通低通滤波器:2100 Hz 已经落进要保留的低频范围。把结果再上采样,也不会自动补回丢失的来源信息。
为什么滤波必须在降采样之前
抗混叠处理的目标,是在改变采样间隔之前,压低新采样率无法正常表示的频率成分。本例的 3900 Hz 超过新边界,应该在仍有足够密的样本时处理;900 Hz 则应尽量保留。这样降低采样率后,高频才不会以强烈的低频成分混进来。
SciPy 官方文档说明,resample_poly 依次进行按 up 上采样、零相位低通 FIR 滤波、按 down 下采样。这里 up=1、down=8,即从 48 kHz 转到 6 kHz;脚本明确使用 Kaiser 参数 5.0 和 padtype="constant",边界之外按零处理。SciPy:resample_poly 的处理流程与边界设置
实测的 2100 Hz 幅度从 0.4 降到约 0.0000369,同时 900 Hz 为约 0.400543。后者有轻微变化,前者也没有严格归零。真实的有限滤波器有自身响应,不能把这次结果描述成逐样本无损,也不能由一个频率的压制效果推出所有频率都达到同一指标。
这里还有一个必须接受的取舍:6 kHz 输出不能按本例的普通音频处理方式,同时保留原来的 3900 Hz 内容。 合理转换是尽量保留目标范围内的内容,并压低会混叠的成分。如果用途需要那些高频,应重新选择输出采样率;不能把它们折叠成低频当作“保留了信息”。
恰好在一半采样率上,也有边界问题
为了检查“采样率只要等于频率两倍就够了”的直觉,脚本还生成了两个 3000 Hz、峰值幅度 0.4 的信号,分别取初相位 0 和 π/2,然后同样直接抽点到 6 kHz。
零初相位时,新样本落在 sin(πn) 上,理论上全为零;实测最大绝对值约 3.23×10^-12。初相位 π/2 时,样本变为正负交替的值,实测峰值为 0.4。同一边界频率,只改变相位,就出现了完全不同的样本表现。
这是纯音的边界对照,不是某款设备的性能测试。它提醒我们:不能把“每周期两个点”理解成任意相位、任意成分都能完整保留。正式处理还应让需要保留的频带处于新边界以内,并给滤波的过渡区域留空间;通带、阻带和过渡区的要求需要结合实际信号决定。Analog Devices:实际滤波器的选择条件
频谱测量也需要写明条件
这些幅度使用 NumPy 的 rfft 计算。它对实数输入返回非负频率部分;默认正向变换不做归一化。因此,脚本将一般频率项的幅值乘 2/N,得到单边峰值幅度,直流和偶数长度下的奈奎斯特项不翻倍。NumPy:rfft 的频率范围、DFT 定义与归一化
为减少本例文件两端滤波瞬态的影响,每端去掉 0.1 秒,只测中央 1.8 秒。该区间里,所比较的纯音都包含整数个周期,恰好落在频率格点上,因此这里采用未加窗的幅度谱。这个安排适合当前的已知纯音,不是让所有真实录音都直接截一段、找最近峰值就能准确测量。
同样,去掉首尾后得到漂亮的稳态结果,不能证明文件端点处理已经满足另一个应用,更不能证明逐块实时转换不会出现接缝。本文执行的是完整数组的离线实验;实际语音、流式处理和各种设备的支持情况都不在测试范围内。
下载后怎样复现
本次环境为 macOS 27.0.1、arm64、Python 3.12.14,依赖固定为 NumPy 2.3.5、SciPy 1.18.1、Matplotlib 3.11.2。下载并解压完整实验包,在目录内执行:
python3.12 -m venv .venv
.venv/bin/python -m pip install -r audio-aliasing-requirements.txt
.venv/bin/python audio-aliasing-lab.py audio-aliasing-output
核心比较可以概括为以下已运行的步骤;完整脚本还负责测量、绘图、边界对照和音频文件读回:
n = np.arange(48000 * 2, dtype=np.float64)
x = 0.4 * np.sin(2 * np.pi * 900 * n / 48000)
x += 0.4 * np.sin(2 * np.pi * 3900 * n / 48000)
stride = x[::8]
filtered = resample_poly(
    x, up=1, down=8, window=("kaiser", 5.0), padtype="constant",
)也可单独下载完整脚本、依赖清单、原始数值结果及运行说明。三份 WAV 没有分别放大到相同峰值,浮点数组转换为 PCM16 时则会产生量化误差,所以复算表格应使用脚本中的浮点测量结果。
用到真实文件时,还要检查什么
这段实验已经证明,样本数、输出采样率和时长都正确,仍不足以保证转换内容正确。正式用途要先确定需要保留的频带,选择容得下它且有滤波余量的输出采样率,再使用包含抗混叠处理的转换方法。完成后还应检查实际文件的通道、幅度、时长、端点以及接收程序是否支持该格式。
这些是从本例提出的实施建议,不是已经完成的语音识别或播放集成。若输入原本已经发生混叠,或者需要保留的频率超过目标输出范围,单靠一次重采样不会满足目标;需要回到原始资料与用途重新决定转换条件。
开头的问题最终落在处理顺序上:直接抽点只改变采样间隔,不会提前消除会折叠的高频;先做合适的抗混叠滤波,才有条件让较低采样率记录目标范围内的内容。 一个合法、时长正确的 WAV 文件,只完成了格式层面的部分检查。能解释每个频率从哪里来、又为何被保留或压低,才说明这次转换确实按预期工作。